SPIS TREŚCI:
W pierwszej części omówiliśmy sygnały związane z jakością i unikalnością treści, takie jak Information Gain, spójność semantyczna czy Cross-Document Factual Consistency. Pokazaliśmy również, dlaczego samo publikowanie „poprawnych” artykułów coraz rzadziej wystarcza do osiągania ponadprzeciętnych wyników w Google. Jeśli nie czytałeś tej części, warto zacząć od Patenty Google i SEO (Część 1): Sygnały treści i Information Gain.
W drugiej części skupiliśmy się na encjach, autorytecie źródła i sposobach budowania topical authority. Omówiliśmy między innymi Entity Salience, Content Clustering oraz mechanizmy pomagające Google określić, czy dana domena rzeczywiście specjalizuje się w konkretnym obszarze tematycznym. Te zagadnienia opisaliśmy szczegółowo w artykule Patenty Google i SEO (Część 2): Encje, Knowledge Graph i autorytet.
W tej części przechodzimy do tematu sygnałów behawioralnych. Przez długi czas dyskusja o wpływie kliknięć, czasu spędzonego na stronie czy powrotów do wyników wyszukiwania opierała się głównie na obserwacjach i spekulacjach. Dopiero proces antytrustowy przeciwko Google oraz wyciek dokumentacji Content Warehouse API dostarczyły informacji, które pozwoliły spojrzeć na ten obszar z zupełnie nowej perspektywy. W dalszej części artykułu przyjrzymy się między innymi systemowi NavBoost, sposobowi interpretowania zachowań użytkowników przez Google oraz temu, jak te mechanizmy wpływają na SEO i widoczność treści w AI Overviews.
Sygnały behawioralne jako czynnik rankingowy Google
Przez wiele lat Google konsekwentnie przekonywało, że kliknięcia użytkowników, czas spędzony na stronie (dwell time) czy powroty do wyników wyszukiwania nie są bezpośrednimi czynnikami rankingowymi. Gary Illyes z zespołu Google Search Relations stwierdził nawet, że teorie o CTR i dwell time jako czynnikach rankingowych to „generally made up crap”, co można luźno przetłumaczyć jako „w większości zmyślone bzdury”. Warto jednak pamiętać, że wypowiedź ta odnosiła się do uproszczonego modelu, w którym pojedyncze kliknięcie lub dodatkowa minuta spędzona na stronie automatycznie wpływałyby na pozycję w wynikach wyszukiwania. Nie wykluczała natomiast wykorzystywania zagregowanych danych o zachowaniach użytkowników w bardziej złożonych systemach rankingowych.
W środowisku SEO temat ten od lat budził wiele dyskusji. Część specjalistów przyjmowała stanowisko Google bez większych zastrzeżeń, inni prowadzili własne eksperymenty i na ich podstawie wysuwali odmienne wnioski. Trzeba jednak podkreślić, że testy SEO mają swoje ograniczenia. Nawet jeśli obserwujemy zmianę pozycji po określonym działaniu, bardzo trudno jednoznacznie stwierdzić, który sygnał był za nią odpowiedzialny, ponieważ na ranking wpływa wiele czynników działających jednocześnie.
Skąd wiemy, że Google analizuje zachowania użytkowników?
Sytuacja znacząco zmieniła się w latach 2023–2024 za sprawą dwóch wydarzeń, które dostarczyły branży SEO znacznie więcej konkretów niż wcześniejsze spekulacje.
- Pierwszym były zeznania Pandu Nayaka, wiceprezesa Google odpowiedzialnego za Search, złożone 18 października 2023 roku podczas procesu United States et al. v. Google LLC (Civil Action No. 1:20-cv-3010, D.D.C.). W opublikowanym transkrypcie rozprawy Nayak potwierdził między innymi, że NavBoost wykorzystuje dane o wcześniejszych kliknięciach użytkowników, jest trenowany na rzeczywistych zachowaniach użytkowników oraz operuje na 13-miesięcznym oknie danych. Określił również NavBoost jako „one of the important signals that we have”, czyli jeden z ważnych sygnałów wykorzystywanych przez Google.
- Drugim wydarzeniem był wyciek dokumentacji Google Search Content Warehouse API w 2024 roku. Upublicznione materiały obejmowały ponad 2500 stron i opisywały 14 014 atrybutów oraz funkcji wykorzystywanych przez API. Dokumenty zostały przeanalizowane między innymi przez Randa Fishkina ze SparkToro oraz Mike’a Kinga z iPullRank. Jednocześnie warto zachować ostrożność przy interpretacji tych danych. Sama obecność określonego atrybutu w dokumentacji nie oznacza jeszcze, że jest on aktywnie wykorzystywany w rankingu ani jaką wagę może mieć w systemie Google.
W późniejszych publikacjach pojawiły się informacje, że dokumenty przekazał Erfan Azimi, założyciel EA Eagle Digital. Azimi publicznie potwierdził swoją rolę w przekazaniu materiałów, jednak szczegóły dotyczące ich pierwotnego źródła wewnątrz Google nie zostały niezależnie i jednoznacznie zweryfikowane.
Pod koniec maja 2024 roku Google potwierdziło autentyczność dokumentów. Jednocześnie podkreśliło, że nie należy wyciągać daleko idących wniosków na podstawie informacji „out-of-context, outdated, or incomplete”, czyli wyrwanych z kontekstu, nieaktualnych lub niekompletnych.
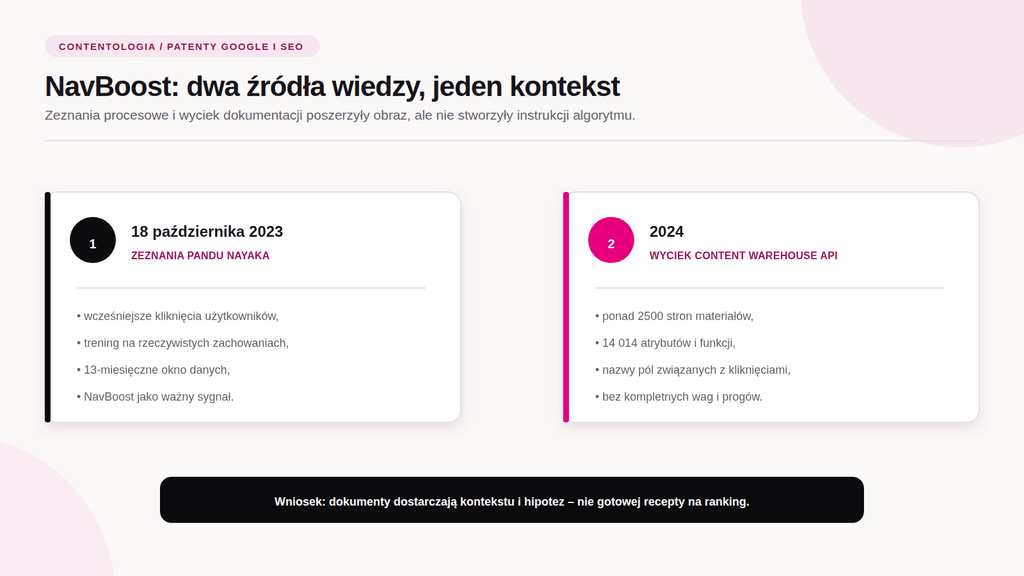
Wyciek pozostaje jednym z najcenniejszych źródeł wiedzy o systemach wykorzystywanych przez Google Search, ale nie jest gotową instrukcją działania algorytmu. Nie zawiera kompletnych wag, progów decyzyjnych ani potwierdzenia, że każdy opisany atrybut jest dziś aktywnym sygnałem rankingowym. Najrozsądniej traktować go jako źródło dodatkowego kontekstu i hipotez, które warto zestawiać z oficjalnymi komunikatami Google, dokumentacją patentową, zeznaniami pracowników firmy oraz niezależnymi analizami technicznymi.
Czym jest NavBoost i jak działa re-ranking wyników?
NavBoost to system, który modyfikuje pozycje dokumentów w wynikach wyszukiwania na podstawie zagregowanych danych telemetrycznych dotyczących zachowania użytkowników. Pandu Nayak, wiceprezes Google ds. Search, podczas procesu antytrustowego określił go jako jeden z ważnych sygnałów wykorzystywanych przez wyszukiwarkę. Na podstawie materiałów procesowych oraz analiz wycieku dokumentacji jest często opisywany jako warstwa re-rankingu, czyli mechanizm wpływający na kolejność wyników już po ich wstępnej ocenie pod kątem zgodności z zapytaniem. Warto jednak zaznaczyć, że Google nie potwierdziło oficjalnie wszystkich szczegółów działania tego systemu. Oznacza to, że tradycyjne sygnały jakościowe, takie jak treść, linki czy encje, nadal odgrywają kluczową rolę przy ocenie strony, natomiast NavBoost może dodatkowo wpływać na jej pozycję i stabilność w wynikach wyszukiwania.
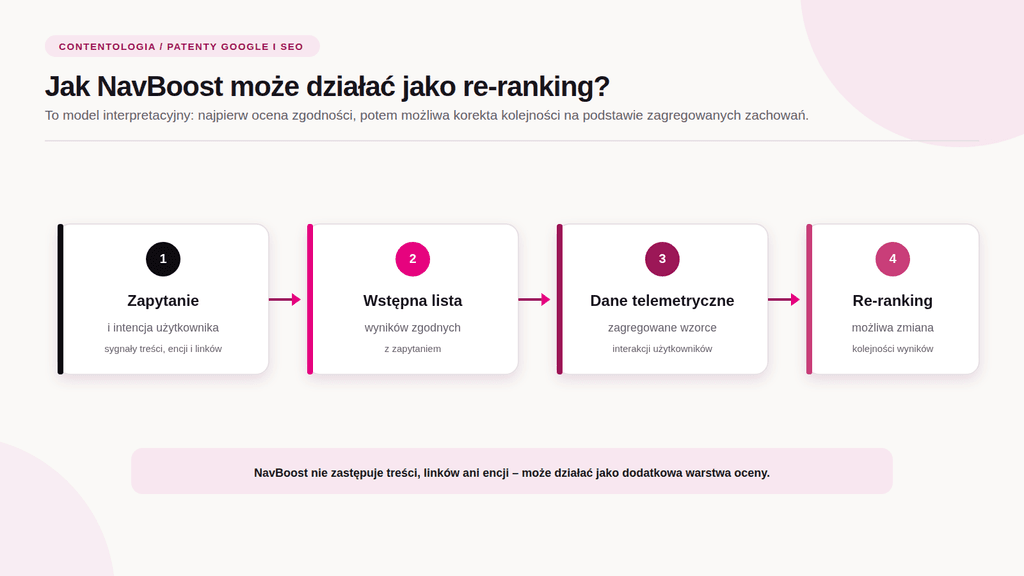
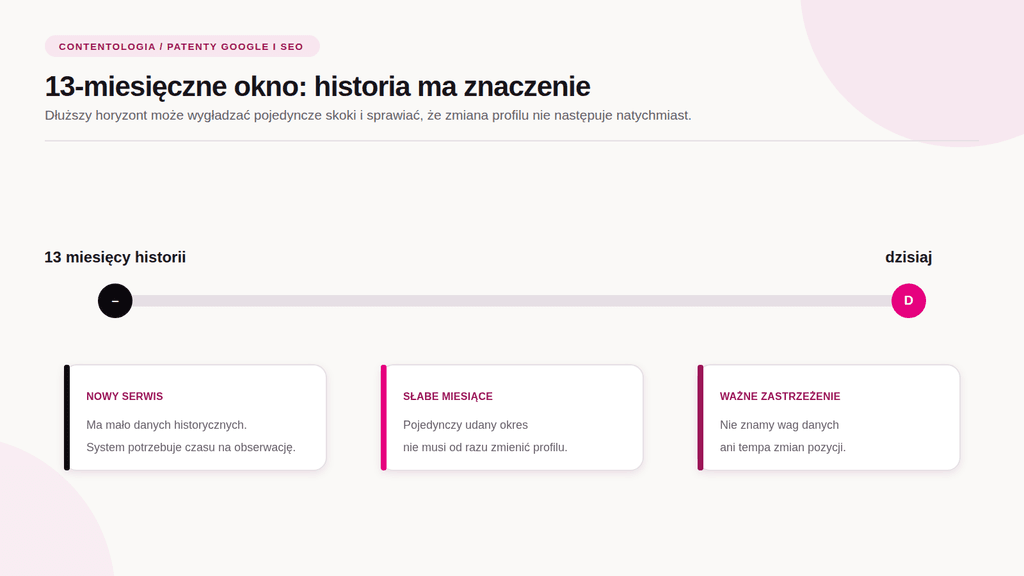
Jak już wspomnieliśmy, z dokumentów ujawnionych w 2024 roku wynika natomiast, że system operuje na 13-miesięcznym kroczącym oknie danych. Taka konstrukcja może mieć istotne konsekwencje:
- Sygnały behawioralne są analizowane w dłuższym horyzoncie czasowym, a nie wyłącznie na podstawie bieżących wyników. Jeżeli strona przez wiele miesięcy generowała słabe sygnały, pojedynczy udany okres może nie wystarczyć do wyraźnej zmiany jej profilu. Trzeba jednak pamiętać, że nie istnieją publicznie dostępne informacje pozwalające określić, jak Google waży dane z poszczególnych okresów ani jak szybko poprawa zachowań użytkowników może przełożyć się na zmiany pozycji.
- Nowe serwisy rozpoczynają działalność bez historycznych danych. Można więc zakładać, że system potrzebuje czasu, aby zgromadzić wystarczającą ilość informacji o zachowaniach użytkowników i na tej podstawie wyciągać bardziej wiarygodne wnioski. Może to być jeden z czynników wpływających na wolniejszy wzrost widoczności nowych projektów, choć trudno uznać go za jedyne wyjaśnienie. Na tempo osiągania efektów SEO wpływają również konkurencyjność branży, jakość treści, profil linkowy, autorytet domeny oraz kwestie techniczne związane z indeksowaniem.
System NavBoost nie ogranicza się wyłącznie do liczenia kliknięć. W ujawnionej dokumentacji można znaleźć między innymi atrybuty goodCliks, BadClics oraz LastLongestClicks. Według interpretacji analityków mogą one odnosić się odpowiednio do kliknięć sugerujących satysfakcję użytkownika, szybkich powrotów do wyników wyszukiwania oraz kliknięć kończących sesję po najdłuższej interakcji ze stroną. W dokumentacji pojawiają się również tak zwane voter tokens, które potencjalnie mogą reprezentować poszczególnych użytkowników.
Może to sugerować, że Google jest w stanie analizować nie tylko samą liczbę kliknięć, ale także wzorce zachowań różnych użytkowników. Trzeba jednak zachować ostrożność w interpretacji tych danych. Nie ma publicznie dostępnych dowodów potwierdzających, że określony stosunek kliknięć do liczby użytkowników jest automatycznie uznawany za podejrzany ani że boty czy sieci proxy są identyfikowane w konkretny, znany sposób. Z tego samego powodu nie można z pełnym przekonaniem stwierdzić, że próby sztucznego zwiększania CTR są z definicji nieskuteczne. Podobnie jest z rozkładem unikalnych tokenów użytkowników. Sam fakt ich występowania wskazuje, że Google może dysponować danymi pozwalającymi odróżniać poszczególnych użytkowników, ale nie stanowi jeszcze dowodu na to, w jaki sposób informacje te są wykorzystywane przy ocenie wyników wyszukiwania.
Taksonomia kliknięć w NavBoost – co goodClicks, badClicks i lastLongestClicks mówią o jakości treści?
Wyciek dokumentacji z 2024 roku ujawnił nazwy pól wykorzystywanych w strukturach danych NavBoost. Nie mamy tutaj do czynienia wyłącznie z teoriami czy modelami interpretacyjnymi tworzonymi przez analityków SEO po fakcie, ale z nazwami zmiennych występujących w ujawnionej dokumentacji Google. Należy jednak pamiętać, że sama nazwa pola nie dowodzi jeszcze, w jaki sposób jest ono obecnie wykorzystywane w rankingu ani jaką ma wagę.
- Jedną z podstawowych kategorii jest goodClicks. Są to kliknięcia, po których użytkownik pozostaje na stronie wystarczająco długo, aby zapoznać się z treścią, i nie wraca od razu do wyników wyszukiwania. W dokumentacji nie wskazano jednego, sztywnego progu czasowego, co samo w sobie jest istotną informacją. Popularne uproszczenia, zgodnie z którymi granicą miałoby być na przykład 30 sekund, nie znajdują potwierdzenia w ujawnionych materiałach. Można jedynie przypuszczać, że ocena „wystarczającego” czasu może zależeć od rodzaju zapytania: przy prostym pytaniu definicyjnym krótsza wizyta może być satysfakcjonująca, natomiast przy rozbudowanym poradniku technicznym użytkownik może potrzebować więcej czasu. Nie ma jednak dowodów na konkretne progi, takie jak kilkanaście sekund czy dwie minuty.
- Przeciwieństwem są badClicks. Ta kategoria obejmuje sytuacje, w których użytkownik szybko wraca do wyników wyszukiwania, a następnie wybiera inny rezultat lub modyfikuje zapytanie. W praktyce jest to formalne potwierdzenie zjawiska określanego jako pogo-sticking. Przez lata Google publicznie dystansowało się od traktowania takich zachowań jako bezpośredniego sygnału rankingowego. Dokumentacja pokazuje jednak, że tego typu interakcje były nie tylko mierzone, ale również uwzględniane w procesie re-rankingu. Jeżeli dla konkretnej strony i konkretnego zapytania zaczyna gromadzić się duża liczba badClicks, NavBoost może stopniowo obniżać jej pozycję, nawet jeśli sama strona spełnia pozostałe wymagania jakościowe.
- Ostatnią analizowaną kategorią są lastLongestClicks. Oznaczają one ostatnie kliknięcie w danej sesji wyszukiwania, po którym użytkownik spędził na stronie najwięcej czasu i nie wrócił już do wyników związanych z tym samym tematem. W interpretacjach jest to często traktowane jako szczególnie wartościowy sygnał, ponieważ może wskazywać, że potrzeba informacyjna użytkownika została zaspokojona i zakończył on poszukiwania. Nie ma jednak potwierdzenia, że jest to najmocniejszy sygnał NavBoosta ani że jego waga jest znana. Jeśli strona regularnie generuje takie zdarzenia dla określonego typu zapytań, może to korelować z lepszą oceną wyniku, ale nie dowodzi to przyczynowego mechanizmu wzmacniania widoczności.
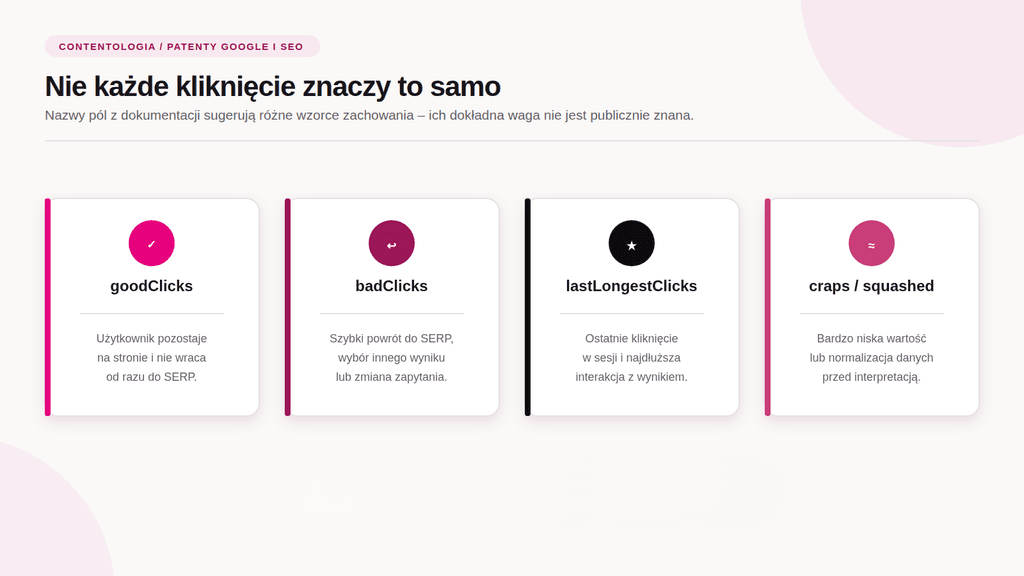
Wyciek ujawnił również pola unsquashedClicks i squashedClicks. Pierwsze odnosi się do danych o kliknięciach przed przetworzeniem, a drugie do tych samych danych po zastosowaniu mechanizmu normalizacji. Sugeruje to, że Google może w pewnym stopniu wygładzać sygnały behawioralne, aby pojedyncze anomalie nie miały zbyt dużego wpływu na ocenę strony. To jednocześnie zabezpieczenie przed manipulacją i powód, dla którego nagły ruch wygenerowany przez wiralową publikację nie musi automatycznie przekładać się na trwały wzrost pozycji w wynikach wyszukiwania.
Przykładowo, jeśli artykuł nagle wygeneruje bardzo duży ruch po udostępnieniu w popularnych mediach społecznościowych, system nie musi automatycznie uznać tego za trwały sygnał jakości. Warto jednak podkreślić, że Google nie ujawniło szczegółów działania tego mechanizmu, dlatego nie wiadomo, w jaki sposób przetwarzane są takie dane ani czy funkcja ta służy również do wykrywania manipulacji kliknięciami. Można jedynie stwierdzić, że nagły skok ruchu nie musi automatycznie prowadzić do trwałego wzrostu pozycji w wynikach wyszukiwania.
Position-Normalized CTR – dlaczego sam CTR niewiele mówi o jakości wyniku?
Jednym z najczęściej błędnie interpretowanych aspektów CTR jako sygnału rankingowego jest założenie, że Google po prostu sprawdza, jaki odsetek użytkowników kliknął dany wynik. Zarówno analizy oparte na wycieku dokumentacji, jak i logika działania systemów opartych na danych o kliknięciach wskazują jednak na bardziej złożone podejście.
Wynik znajdujący się na pierwszej pozycji niemal zawsze osiąga wyższy CTR niż wynik na pozycji dziesiątej. Nie wynika to automatycznie z lepszej jakości strony, lecz przede wszystkim z jej ekspozycji w SERP. Gdyby system analizował wyłącznie surowy współczynnik klikalności, mógłby wpadać w błędne koło: strona zajmująca pierwszą pozycję otrzymywałaby najwięcej kliknięć właśnie dlatego, że jest na pierwszym miejscu, a pozostałe wyniki miałyby ograniczone możliwości poprawy swojej pozycji. Analizy wycieku sugerują, że NavBoost może oceniać kliknięcia w relacji do oczekiwań dla danej pozycji, a nie wyłącznie na podstawie surowego CTR. Google nie opublikowało jednak wzoru ani progów takiej normalizacji.
Załóżmy hipotetycznie, że dla określonej frazy typowy CTR na pozycji czwartej wynosi około 5%, a strona regularnie osiąga 9%. Dla systemu opartego na danych behawioralnych może to być sygnał, że wynik przyciąga uwagę użytkowników skuteczniej, niż można by oczekiwać na tej pozycji. Może to oznaczać, że tytuł i meta description lepiej odpowiadają na intencję wyszukiwania niż wyniki znajdujące się wyżej. Jeżeli taka sytuacja utrzymuje się przez dłuższy czas, może stanowić jeden z sygnałów branych pod uwagę przy ocenie wyniku. Analogicznie działa to w drugą stronę: jeżeli wynik zajmujący pierwszą pozycję osiąga CTR wyraźnie poniżej oczekiwań, może to sugerować, że użytkownicy nie uznają go za najbardziej atrakcyjną odpowiedź na swoje zapytanie. Przyczyną może być niedopasowany snippet albo tytuł, który nie odzwierciedla tego, czego faktycznie szukają użytkownicy.
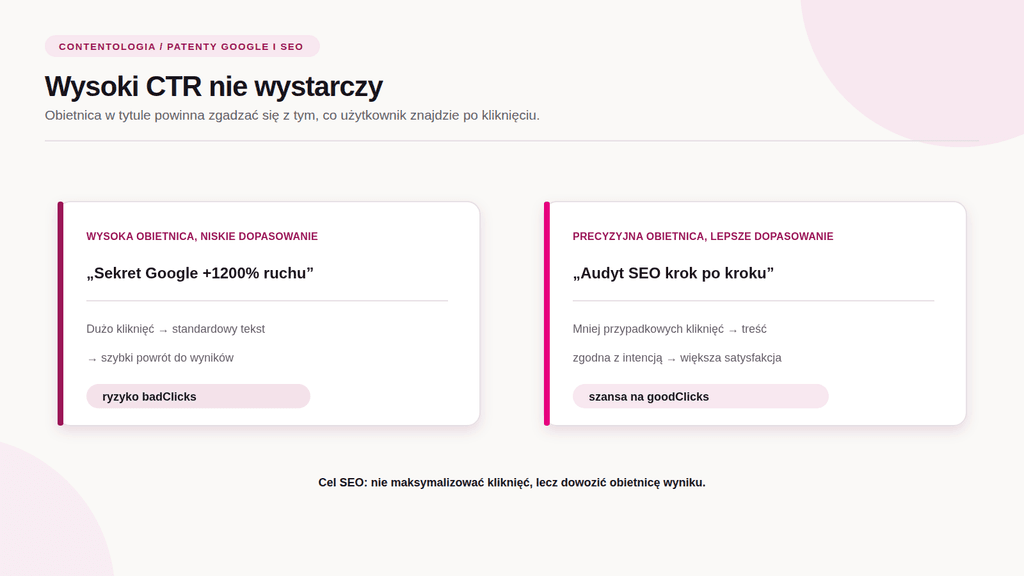
Jeżeli tytuł zwiększa klikalność dzięki sensacyjnej obietnicy, której treść nie realizuje, może prowadzić do szybkich powrotów do wyników wyszukiwania, czyli zachowań zapisywanych w dokumentacji jako badClicks. Znacznie lepiej sprawdzają się komunikaty precyzyjnie opisujące zawartość strony i jasno pokazujące, kto skorzysta z przedstawionych informacji. Takie podejście przyciąga użytkowników rzeczywiście zainteresowanych treścią i zwiększa szansę na kliknięcia klasyfikowane jako goodClicks lub lastLongestClicks, które w interpretacjach analityków mogą świadczyć o satysfakcji z wyniku.
PRZYKŁAD OD CONTENTOLOGII: CTR w NavBoost
Przykładowo artykuł zatytułowany „Poznański pozycjoner zdradza sekret Google, który zwiększył ruch o 1200%” może przyciągnąć wiele kliknięć, ale jeśli użytkownik trafi na standardowy tekst o podstawach SEO, bardzo szybko wróci do wyników wyszukiwania. W takiej sytuacji wysoki CTR nie musi oznaczać sukcesu, ponieważ za kliknięciami może nie iść satysfakcja użytkownika.
Zupełnie inaczej działa tytuł dopasowany do rzeczywistej intencji wyszukiwania. Dla frazy „jak przeprowadzić audyt SEO” większą wartość może mieć nagłówek „Audyt SEO krok po kroku – lista kontrolna i najczęstsze błędy”, ponieważ jasno komunikuje zawartość strony. Użytkownik od początku wie, czego może się spodziewać, a jeśli znajdzie dokładnie to, czego szukał, wzrasta szansa na wygenerowanie goodClicks lub lastLongestClicks.
Podobny mechanizm widać przy zapytaniach produktowych. Tytuł „Najlepszy laptop 2026 roku – ranking ekspertów” może generować dużo kliknięć, ale jeżeli użytkownik szuka komputera do pracy w budżecie do 4000 zł, bardziej trafny może być nagłówek „Najlepsze laptopy do 4000 zł w 2026 roku – ranking do pracy i nauki”. Taki tytuł może przyciągać mniej kliknięć, ale lepiej odpowiada na konkretną potrzebę użytkownika. Z perspektywy NavBoosta istotne jest nie samo zwiększenie liczby kliknięć, lecz dopasowanie wyniku do intencji i dostarczenie treści, która rzeczywiście odpowiada na potrzebę informacyjną
Dlaczego historia interakcji ma znaczenie w NavBoost i dlaczego silne marki wolniej tracą pozycje?
Duże wydawnictwa i rozpoznawalne marki często utrzymują wysokie pozycje nawet na treściach, które trudno uznać za najlepsze w swojej kategorii. Dla mniejszych serwisów bywa to frustrujące, ale nie musi oznaczać ręcznych interwencji Google czy istnienia „tajnej listy uprzywilejowanych domen”.
Jeżeli system rzeczywiście wykorzystuje 13-miesięczne okno danych, duże marki dysponują zwykle znacznie większą liczbą zarejestrowanych interakcji niż nowe lub niszowe serwisy. Warto jednak pamiętać, że NavBoost prawdopodobnie nie działa jak jeden wspólny „wynik jakości” dla całej domeny. Analizy wycieku sugerują, że dane są gromadzone przede wszystkim dla konkretnych par zapytanie–dokument. W praktyce oznacza to, że ten sam serwis może generować bardzo dobre sygnały dla jednego zestawu fraz i znacznie słabsze dla innego.
Załóżmy, że duży portal informacyjny zgromadził w ciągu ostatnich 13 miesięcy bardzo dużo pozytywnych sygnałów użytkowników dla wielu zapytań i wielu adresów URL. Jeśli opublikuje jeden słabszy artykuł, który wygeneruje 500 badClicks, wpływ tego materiału na wyniki dla innych zapytań nie musi być automatycznie zauważalny. Nie oznacza to jednak, że dobre sygnały z całej domeny automatycznie „zneutralizują” złe sygnały jednego artykułu. Google nie ujawniło sposobu agregowania i ważenia tych danych.
Bufor wynikający z 13-miesięcznego okna nie jest nieskończony. Jeżeli serwis przez wiele miesięcy publikuje treści, które nie spełniają oczekiwań użytkowników, nawet bogata historia pozytywnych sygnałów może stopniowo tracić znaczenie. Spadki widoczności w latach 2023–2025 dotyczyły również dużych wydawców i rozpoznawalnych marek, choć nie można przypisywać ich wyłącznie NavBoostowi ani twierdzić, że były wywołane konkretnie tym systemem . W dłuższej perspektywie NavBoost może oceniać przede wszystkim to, jak użytkownicy reagują na konkretne wyniki dla konkretnych zapytań. Silna marka może więc wolniej tracić pozycje, ale nie jest przed tym procesem automatycznie chroniona.
Zapytania brandowe a SEO – czy rozpoznawalność marki wpływa na wyniki wyszukiwania?
Dotychczas skupialiśmy się na sygnałach behawioralnych związanych z kliknięciami w wyniki wyszukiwania. Warto jednak spojrzeć szerzej: zanim użytkownik kliknie w jakikolwiek rezultat, może wpisać w Google nazwę marki albo połączyć ją z konkretnym tematem. W dyskusjach SEO mówi się wtedy o zapytaniach brandowych i nawigacyjnych, które mogą dostarczać wyszukiwarce dodatkowego kontekstu na temat rozpoznawalności witryny.
Publicznie dostępnym punktem odniesienia jest patent Google zatytułowany Ranking Search Results. Opisuje on możliwość wykorzystania tzw. reference queries, czyli zapytań brandowych i nawigacyjnych, jako „implied links”, czyli sygnałów podobnych do linków, które mogą modyfikować ranking wyników. Patent nie dowodzi jednak, że Google obecnie stosuje dokładnie ten mechanizm w swojej wyszukiwarce ani że zapytania brandowe są częścią NavBoosta.
U podstaw tej koncepcji leży obserwacja, że użytkownicy mogą łączyć konkretną markę z określoną tematyką. Jeżeli regularnie pojawiają się zapytania typu „Contentologia SEO”, może to wskazywać, że część osób świadomie kojarzy daną markę z danym obszarem. Patent opisuje takie zapytania jako reference queries, ponieważ odnoszą się one do konkretnej witryny lub marki.
Navigational Queries – kiedy użytkownik szuka Twojej marki, a nie informacji
Wyszukiwania nawigacyjne to zapytania, których celem nie jest znalezienie odpowiedzi na pytanie, lecz dotarcie do konkretnej strony, firmy lub usługi. Użytkownik wpisujący „Contentologia blog” albo „Ahrefs login” zazwyczaj wie już, dokąd chce trafić.
W drugiej części przewodnika o SEO i Patentach Google omawialiśmy topical authority, czyli potencjalny sygnał budowany przez historię publikacji w konkretnej niszy. Analiza sygnałów behawioralnych pokazuje jednak, że sam dorobek contentowy to tylko część układanki. Topical authority bywa opisywana przede wszystkim przez historię publikacji i konsekwentne rozwijanie określonego obszaru tematycznego. Zapytania brandowe dotyczą natomiast zachowania użytkowników: pokazują, że część osób samodzielnie kojarzy markę z konkretną dziedziną. Część analityków SEO sugeruje, że zapytania brandowe mogą być trudniejsze do sztucznego wygenerowania niż klasyczne elementy on-site, ale nie ma publicznych danych pozwalających to jednoznacznie potwierdzić.
Dobrze pokazuje to prosty przykład. Jeżeli ktoś wpisuje w Google frazę „audyt SEO”, wyszukiwarka otrzymuje informację o potrzebie użytkownika. Jeżeli natomiast regularnie pojawiają się zapytania typu „Contentologia audyt treści SEO”, może to sugerować, że użytkownicy zaczynają postrzegać konkretną markę jako źródło wiedzy w tym obszarze. Nie można jednak stwierdzić, że sama liczba takich zapytań automatycznie podnosi pozycje strony. Patent opisuje system, który mógłby wykorzystywać takie zapytania jako czynnik modyfikujący ranking, ale nie potwierdza, że Google obecnie stosuje go w tej formie
W praktyce oznacza to, że nawet dobrze zoptymalizowana strona może nie korzystać z tego rodzaju sygnału, jeśli użytkownicy nie wyszukują jej nazwy w powiązaniu z tematyką, w której działa. Z kolei marka, którą użytkownicy regularnie wpisują w wyszukiwarkę razem z określonymi frazami, może stopniowo budować rozpoznawalność w danej niszy. Nie dzieje się to jednorazowo, lecz kumuluje w czasie.
Z tego punktu widzenia content marketing, newsletter, podcast czy aktywność w mediach społecznościowych nie są jedynie dodatkiem do SEO. Mogą zwiększać prawdopodobieństwo, że użytkownik zapamięta markę i następnym razem wpisze jej nazwę bezpośrednio w wyszukiwarce. Nie są one jednak dowodem ekspertyzy ani gwarancją wyższych pozycji. Działania wizerunkowe nie zastępują jakości treści, technicznego SEO ani profilu linkowego, ale mogą wpływać na to, jak użytkownicy zapamiętują i wyszukują markę. Dla mniejszych serwisów oznacza to, że warto nie tylko optymalizować strony pod konkretne frazy, ale też konsekwentnie budować rozpoznawalność w swojej niszy.
Jak AI wpływa na sygnały behawioralne użytkowników?
Zmiany w sposobie prezentowania wyników wyszukiwania wpływają nie tylko na widoczność stron, ale również na rodzaj sygnałów behawioralnych generowanych przez użytkowników. Jednym z najważniejszych przykładów takiej zmiany jest wprowadzenie AI Overviews.
W maju 2023 roku Google zapowiedziało eksperyment Search Generative Experience (SGE), który rok później został udostępniony użytkownikom pod nazwą AI Overviews. Funkcja zaczęła pojawiać się przy coraz większej liczbie zapytań. Choć jej zasięg różni się w zależności od rynku, branży i metodologii pomiaru, kierunek zmian jest wyraźny – generowane przez AI odpowiedzi stały się stałym elementem wyszukiwarki Google.
Analizy działania AI Overviews opisują proces pozyskiwania treści jako model składający się z kilku warstw:
- Pierwsza obejmuje zapytania dosłowne, czyli bardzo zbliżone do tego, co użytkownik wpisał w wyszukiwarkę. Na tym poziomie nadal ogromne znaczenie mają klasyczne elementy SEO, takie jak trafność treści, autorytet domeny czy sygnały rankingowe omówione wcześniej.
- Druga warstwa dotyczy zapytań semantycznie powiązanych. Model nie ogranicza się wyłącznie do głównej frazy, ale próbuje zrozumieć cały kontekst problemu. Jeżeli użytkownik szuka informacji o audycie SEO, system może równolegle analizować treści dotyczące indeksacji, linkowania wewnętrznego, Core Web Vitals czy analizy logów serwera. Na tym etapie najlepsze efekty dają materały oferujące szerokie pokrycie tematu oraz dobrze rozwinięte klastry treści.
- Trzecia warstwa jest związana z tak zwanymi zapytaniami wnioskowanymi. Chodzi o pytania, których użytkownik jeszcze nie zadał, ale które z dużym prawdopodobieństwem pojawią się za chwilę jako kolejny etap procesu poszukiwania informacji. Jeżeli ktoś szuka informacji o audycie SEO, naturalnym kolejnym krokiem mogą być pytania o narzędzia, koszty, priorytety wdrożeń czy najczęstsze błędy. Model próbuje przewidywać takie ścieżki i korzysta z treści, które odpowiadają nie tylko na główne zapytanie, ale również na pytania pojawiające się wokół niego.
Artykuł odpowiadający wyłącznie na jedno pytanie może nadal dobrze rankować w klasycznych wynikach. Treści uznawane przez AI za wartościowe źródło zwykle dostarczają bardziej rozbudowanych informacji, np. wyjaśniają kotekst i rozwiewają wątpliwości, które mogą pojawić się w miarę zagłębiania tematu. W modelu opartym na generatywnej AI właśnie takie treści mają największą szansę zostać wybrane jako źródło odpowiedzi.
Więcej o AI w wyszukiwarce przeczytasz na naszym blogu: Jak AI Mode Google wpływa na sposób poszukiwania informacji?
Cztery warstwy sygnałów w kompletnej strategii contentowej Contentologia
Jeżeli połączymy wnioski z wszystkich trzech części tego przewodnika, otrzymamy spójny model budowania treści pod współczesne algorytmy Google. W praktyce nie chodzi o pojedynczy czynnik rankingowy ani o znalezienie jednego „sekretu SEO”. Skuteczność wynika z połączenia czterech warstw, które wzajemnie się uzupełniają. Każda kolejna opiera się na poprzedniej i trudno oczekiwać dobrych wyników, jeśli jedna z nich jest zaniedbana.
- Pierwszą warstwą jest treść. To fundament całego systemu. W tej warstwie liczy się unikalny Information Gain (czyli wartość dodana względem istniejących treści), spójność semantyczna pomiędzy sekcjami artykułu, zgodność danych liczbowych z informacjami zawartymi w Schema.org oraz przypisywanie kluczowych twierdzeń do wiarygodnych źródeł. Bez tych elementów algorytm ma ograniczone podstawy, aby uznać dokument za bardziej wartościowy od konkurencyjnych materiałów, nawet jeśli pozostałe sygnały wypadają korzystnie.
- Drugą warstwą są encje, czyli tożsamość treści. Główna encja tematyczna powinna być jednoznacznie widoczna w tytule, nagłówku H1 i pierwszych akapitach. Duże znaczenie ma również stosowanie specjalistycznej terminologii o wysokim IDF (Inverse Document Frequency) zamiast ogólnych, zamiennych sformułowań. W przypadku autorów ważne staje się także powiązanie z realną, możliwą do zweryfikowania tożsamością poprzez atrybuty sameAs w Schema.org. Nawet bardzo dobry tekst może mieć problem z budowaniem autorytetu, jeśli algorytm nie potrafi jednoznacznie określić, kogo dotyczy i kto za nim stoi.
- Trzecia warstwa to autorytet. Jest budowana najwolniej, ale jednocześnie najtrudniej ją skopiować. Składają się na nią lata konsekwentnych publikacji w określonej tematyce, cytowania przez wiarygodne źródła, wzrost liczby zapytań brandowych oraz stopniowo budowana rozpoznawalność marki. To właśnie tutaj powstaje kapitał, który sprawia, że użytkownicy zaczynają kojarzyć konkretną domenę z określonym obszarem wiedzy.
- Czwarta warstwa obejmuje sygnały behawioralne. Można ją traktować jako etap weryfikacji wszystkich wcześniejszych założeń przez realnych użytkowników. To tutaj znaczenie mają tytuły generujące CTR wyższy od średniej dla danej pozycji, treści skutecznie realizujące intencję wyszukiwania oraz struktura artykułu, która pozwala szybko znaleźć odpowiedź na zadane pytanie. W kontekście AI Overviews szczególnego znaczenia nabiera również sposób budowania akapitów. Pierwsze zdanie każdej sekcji coraz częściej powinno działać jak samodzielna odpowiedź na pytanie wynikające z nagłówka — choć warto pamiętać, że jest to interpretacja analityków, a nie oficjalne wytyczne Google.
Najważniejsze jest jednak to, że żadna z tych warstw nie funkcjonuje w oderwaniu od pozostałych. Strona może zawierać wyjątkowo wartościowy Information Gain, ale jeśli tytuł nie zachęca do kliknięcia, trudno będzie utrzymać wysokie pozycje w środowisku opartym na sygnałach behawioralnych. Z kolei wysoki CTR nie pomoże w sytuacji, gdy artykuł jest niespójny semantycznie i nie dostarcza wystarczającego kontekstu, aby zostać wykorzystanym w AI Overviews. Podobnie działa warstwa autorytetu. Nawet silna marka i rozpoznawalny autor nie zbudują trwałej przewagi, jeśli publikowane treści są rozproszone tematycznie i nie tworzą wyraźnego obszaru specjalizacji.
Jeśli chcesz sprawdzić, które z tych obszarów ograniczają dziś widoczność Twojej strony, zobacz naszą ofertę SEO lub wypełnij krótki brief. Przeanalizujemy Twój serwis i pokażemy, gdzie znajdują się największe rezerwy wzrostu ruchu organicznego.
FAQ Najczęściej zadawane pytania o NavBoost i sygnały behawioralne Google
Czy Google oficjalnie potwierdziło, że NavBoost istnieje i jest używany w rankingu?
Tak, istnienie NavBoosta zostało potwierdzone w zeznaniach Pandu Nayaka podczas procesu antytrustowego USA v. Google w 2023 roku. Nayak zeznał, że NavBoost jest jednym z ważnych sygnałów wykorzystywanych przez Google, ale nie ujawnił szczegółów jego działania ani wagi w rankingu.
Czy CTR jest czynnikiem rankingowym w Google?
Nie ma oficjalnego potwierdzenia, że surowy CTR jest bezpośrednim czynnikiem rankingowym. Analizy wycieku dokumentacji sugerują, że Google może wykorzystywać dane o kliknięciach w bardziej złożony sposób, np. poprzez porównywanie rzeczywistego CTR z oczekiwanym CTR dla danej pozycji. Nie oznacza to jednak, że samo zwiększenie liczby kliknięć automatycznie podniesie pozycję strony. W praktyce podczas audytów SEO realizowanych przez Contentologię częściej obserwujemy zależność między CTR a jakością ruchu niż między CTR a samą pozycją w wynikach wyszukiwania.
Czy mogę manipulować sygnałami behawioralnymi, np. kupując kliknięcia?
Próby manipulacji sygnałami behawioralnymi (np. kupowanie kliknięć, używanie botów) są ryzykowne i niezgodne z wytycznymi Google. Dokumentacja wycieku sugeruje, że Google dysponuje mechanizmami wykrywania nienaturalnych wzorców kliknięć, takimi jak squashing danych czy analiza voter tokens. Z doświadczeń Contentologii wynika również, że działania nastawione na sztuczne poprawianie wskaźników niemal nigdy nie dają trwałych efektów. Znacznie lepiej sprawdza się poprawa jakości treści i dopasowania jej do intencji wyszukiwania.
Jak szybko NavBoost reaguje na zmiany w zachowaniach użytkowników?
Nie ma publicznie dostępnych informacji na temat tempa reakcji NavBoosta. System operuje na 13-miesięcznym oknie danych, co sugeruje, że zmiany mogą być stopniowe i rozłożone w czasie. Pojedyncze zdarzenia (np. jeden artykuł z dużą liczbą badClicks) mogą mieć mniejszy wpływ niż długoterminowe trendy.
Czy nowe domeny mają mniejsze szanse na wysokie pozycje z powodu braku historii danych behawioralnych?
Brak historii danych behawioralnych może być jednym z czynników wpływających na wolniejszy wzrost widoczności nowych domen, ale nie jest to jedyny ani potwierdzony mechanizm. Na tempo osiągania efektów SEO wpływają również konkurencja, jakość treści, profil linków, autorytet domeny i techniczne aspekty indeksowania. Analizując projekty rozwijane przez Contentologię, regularnie obserwujemy, że dobrze zaprojektowany content i trafne pokrycie intencji użytkownika potrafią znacząco skrócić czas potrzebny do zdobycia pierwszej widoczności.
Czy zapytania brandowe i nawigacyjne wpływają na ranking?
Patent Google US8682892B1 opisuje możliwość wykorzystania zapytań brandowych i nawigacyjnych (reference queries) jako „implied links”, które mogą modyfikować ranking. Nie ma jednak oficjalnego potwierdzenia, że Google obecnie stosuje ten mechanizm w swojej wyszukiwarce ani że zapytania brandowe są bezpośrednio wykorzystywane w NavBooście.
Jak mierzyć sygnały behawioralne swojej strony?
Sygnały behawioralne można pośrednio mierzyć za pomocą narzędzi takich jak Google Search Console (CTR, pozycje), Google Analytics 4 (czas na stronie, współczynnik odrzuceń, zaangażowanie) oraz narzędzi do analizy zachowań użytkowników (hotjary, nagrania sesji). Pamiętaj, że metryki z GA4 (np. bounce rate) nie są bezpośrednimi sygnałami rankingowymi, ale mogą pomagać w zrozumieniu zachowań użytkowników.
Bibliografia i źródła
- Google Search Central: AI-generated content
https://developers.google.com/search/docs/best-practices/ai-generated-content - Google Search Central: How Google ranks search results
https://developers.google.com/search/docs/how-search-works/rank-modification - Google Knowledge Panel: About knowledge panels
https://support.google.com/knowledgepanel/answer/9163198?hl=en - Google Knowledge Panel: How Google’s Knowledge Graph works
https://support.google.com/knowledgepanel/answer/9787176?hl=en - Google Blog: About Knowledge Graph and Knowledge Panels
https://blog.google/products-and-platforms/products/search/about-knowledge-graph-and-knowledge-panels/ - US8682892B1: Ranking Search Results (reference queries, implied links)
https://patents.google.com/patent/US8682892B1/en - US9659064B1: Obtaining authoritative search results
https://patents.google.com/patent/US9659064B1/en - USA v. Google LLC, Civil Action No. 1:20-cv-3010 (D.D.C.) – transkrypt przesłuchania P. Panduranga Nayaka, 18 października 2023 r.
https://thecapitolforum.com/wp-content/uploads/2023/10/101823-USA-v-Google-PM.pdf - Search Engine Land: How Google Search and ranking works, according to Google’s Pandu Nayak
https://searchengineland.com/how-google-search-ranking-works-pandu-nayak-435395 - SparkToro: An anonymous source shared thousands of leaked Google Search API documents
https://sparktoro.com/blog/an-anonymous-source-shared-thousands-of-leaked-google-search-api-documents-with-me-everyone-in-seo-should-see-them/ - Wikipedia: 2024 Google Search documentation leak
https://en.wikipedia.org/wiki/2024_Google_Search_documentation_leak - SEO Stack: NavBoost Unpacked – What the Google Content Warehouse Leak Actually Tells Us
https://www.seo-stack.io/blog/navboost-unpacked-what-the-google-content-warehouse-leak-actually-tells-us-about-click-based-ranking - Trapilot: NavBoost Unpacked – Google leak coverage
https://trapilot.ai/google-leak/coverage/seostack-navboost-unpacked - NavBoost.com: NavBoost Click Types: goodClicks, badClicks, lastLongestClicks
https://navboost.com/navboost-click-types/ - NavBoost.com: How NavBoost Works
https://navboost.com/how-navboost-works/ - NavBoost.com: Dwell Time SEO
https://navboost.com/dwell-time-seo/ - NavBoost.com: CTR by Google Search Position
https://navboost.com/ctr-by-position/ - NavBoost.com: CTR Curve – Expected CTR
https://navboost.com/ctr-curve-expected-ctr/ - NavBoost.com: Branded Search as a Ranking Signal
https://navboost.com/branded-search-ranking/ - Webselect Agency: What is NavBoost? Google’s click-based ranking system
https://webselect.agency/what-is-navboost-google-ranking-system/ - Webselect Agency: Chrome data as a ranking signal
https://webselect.agency/chrome-data-ranking-signal-google-leak/ - Hobo: NavBoost – How Google uses large-scale user interaction data
https://www.hobo-web.co.uk/navboost-how-google-uses-large-scale-user-interaction-data-to-rank-websites/ - Search Engine Journal: Google’s „Branded Search” Ranking Factor Patent
https://www.searchenginejournal.com/googles-branded-search-patent-for-ranking-search-results/524083/ - Search Engine Journal: Four Reasons You Can’t Ignore Branded SEO in 2025
https://www.searchenginejournal.com/similarweb-branded-seo-in-2025-spa/527378/ - Moz: Navigational Keywords
https://moz.com/learn/seo/navigational-keywords - Alejandro Meyerhans: Implied Links Patent (US8682892B1) analysis
https://alejandromeyerhans.com/research/US8682892B1-implied-links-patent/ - Google Search Central: AI Overviews
https://developers.google.com/search/blog/ai-overviews - Search Engine Land: Unpacking Google’s massive search documentation leak
https://searchengineland.com/unpacking-googles-massive-search-documentation-leak-442716 - USPTO: Search for Patents
https://www.uspto.gov/patents/search - Google Patents: Advanced Search
https://patents.google.com/advanced - Grafiki wygenerowane w AI